用量统计
1 概述
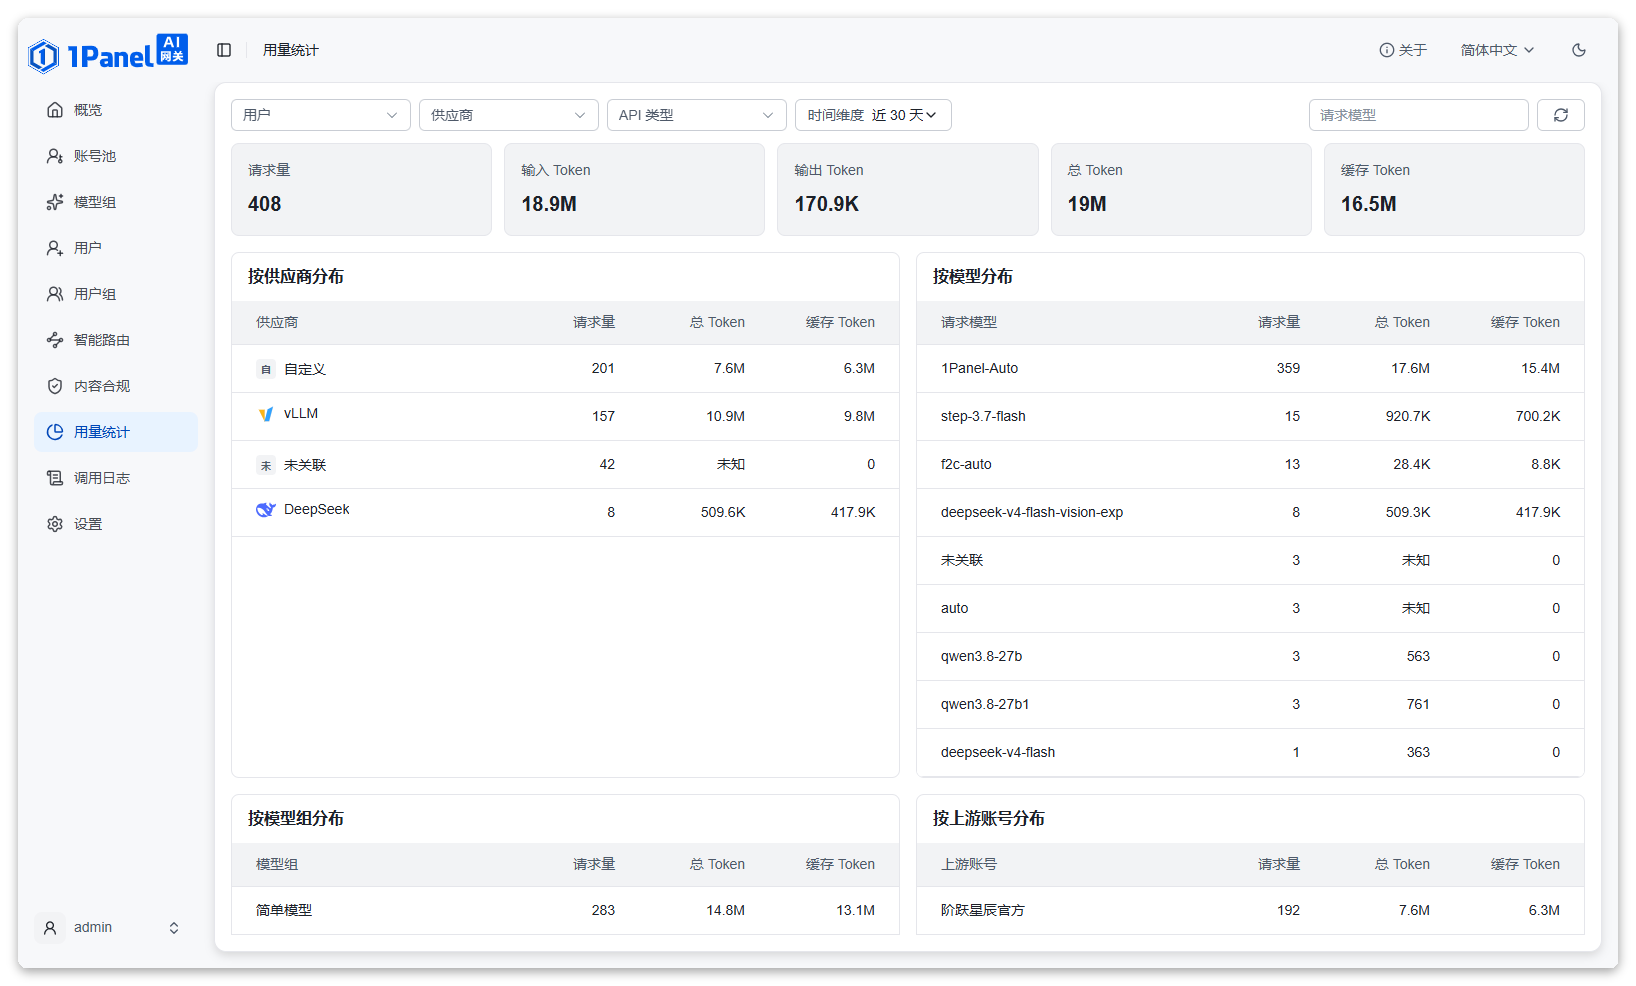
用量统计页汇总展示网关在指定时间范围内的模型调用总量与分布,帮助管理员掌握各供应商、模型、用户的使用情况。页面由筛选区、总览卡片和分布表格组成。
2 筛选项
当需要分析特定范围(如某用户、某供应商)的用量时,可先通过筛选缩小统计范围,使指标卡与分布表仅反映符合条件的用量。
页面顶部提供以下筛查方式:
-
按用户筛选:仅统计指定用户的用量。
-
按供应商筛选:仅统计指定供应商或账号的用量。
-
按 API 类型筛选:仅统计指定类型的调用用量。
-
按时间维度筛选:选择统计的时间范围,如近 7 天、近 30 天。
-
按请求模型检索:输入模型名称,聚焦特定模型的用量。
3 总览指标
页面顶部以指标卡形式展示整体用量概况,主要包括:
-
请求量:统计范围内的请求总数。
-
输入 Token:调用产生输入消耗的 Token 数。
-
输出 Token:调用产生输出消耗的 Token 数。
-
总 Token:输入与输出 Token 之和,反映总体消耗。
-
缓存 Token:命中缓存的 Token 数,可反映缓存带来的用量节省。
-
已知 Token 请求:能够成功采集到 Token 用量的请求数。
-
缺失用量请求:未能采集到 Token 用量的请求数(如上游异常返回未知用量)。
4 分布表格
页面下方通过多张分布表,从不同维度展示请求量与 Token 消耗数据。各分布表均包含请求量、总 Token、缓存 Token等指标,可按需查看:
-
按供应商分布:了解各供应商(及账号)的用量占比,便于评估不同供应商的使用情况。
-
按模型分布:了解各请求模型的用量,识别消耗较大的模型。
-
按模型组分布:从模型组维度观察用量,了解分组层面的资源消耗。
-
按上游账号分布:了解各上游账号的实际承载,便于评估账号负载与成本。
-
按用户组分布:从用户组维度观察用量,了解不同用户组的消耗情况。
-
按用户分布:逐用户查看用量,识别用量较大的个体用户。
如同一分析需要从多个角度切入,可据此交叉查看,从而全面了解用量结构。例如先通过"按用户分布"发现高消耗用户,再结合"按模型分布"判断其消耗主要落在哪些模型上。
5 注意事项
-
先筛选再分析:数据量较大时,建议先设置用户、供应商或时间范围,再查看各维度分布,结果更聚焦。
-
关注总 Token 与缓存 Token:总 Token 反映总体成本,缓存 Token 反映命中缓存带来的节省,两者是成本分析的关键。
-
注意已删除资源:分布表中若上游账号或资源名称带有"已删除"标记,表示该资源已不可用,历史用量仍会保留统计。